Das beste Modell ist das, das Ihre Arbeit ins Ziel bringt.
Wir verkaufen nicht das billigste Token und jagen keinem einzelnen umstrittenen Leaderboard-Wert hinterher. Palgu testet nach Entwickler-Anwendungsfällen und routet jede Anfrage automatisch hinter einem einzigen Endpunkt an das Modell, das die Arbeit erledigt. Unten sehen Sie, wie wir routen, und die Belege dafür.
„Ein Feature über viele Dateien hinweg implementieren oder refaktorisieren“
Coding-Agent
Alltägliches Multi-File-Coding wird an GLM-5.3 geroutet, den Standard von Palgu für substanzielle Aufgaben (ADR-079) und Sieger unseres internen Standard-A/B-Tests: Es lieferte auf Anhieb eine funktionierende 8/8-App zu den niedrigsten Kosten der drei getesteten Modelle. Kritische Aufgaben eskalieren zu Claude Opus + Council; Sie können jedes Modell pro Anfrage fixieren. Wir stufen einen Coding-Schritt niemals stillschweigend allein aus Budgetgründen herab.
Palgu routet an
GLM
Z.ai
Produktivitätsergebnis
PRs beim ersten Versuch korrekt, weniger Review-Schleifen
Beleg · Interner Standard-A/B-Test
GLM-5.3 8/8 im ersten Anlauf · gewinnt den Preis×Qualität×Geschwindigkeit-Score gegen kimi-k3 & GLM-5.2 · im Browser verifiziert
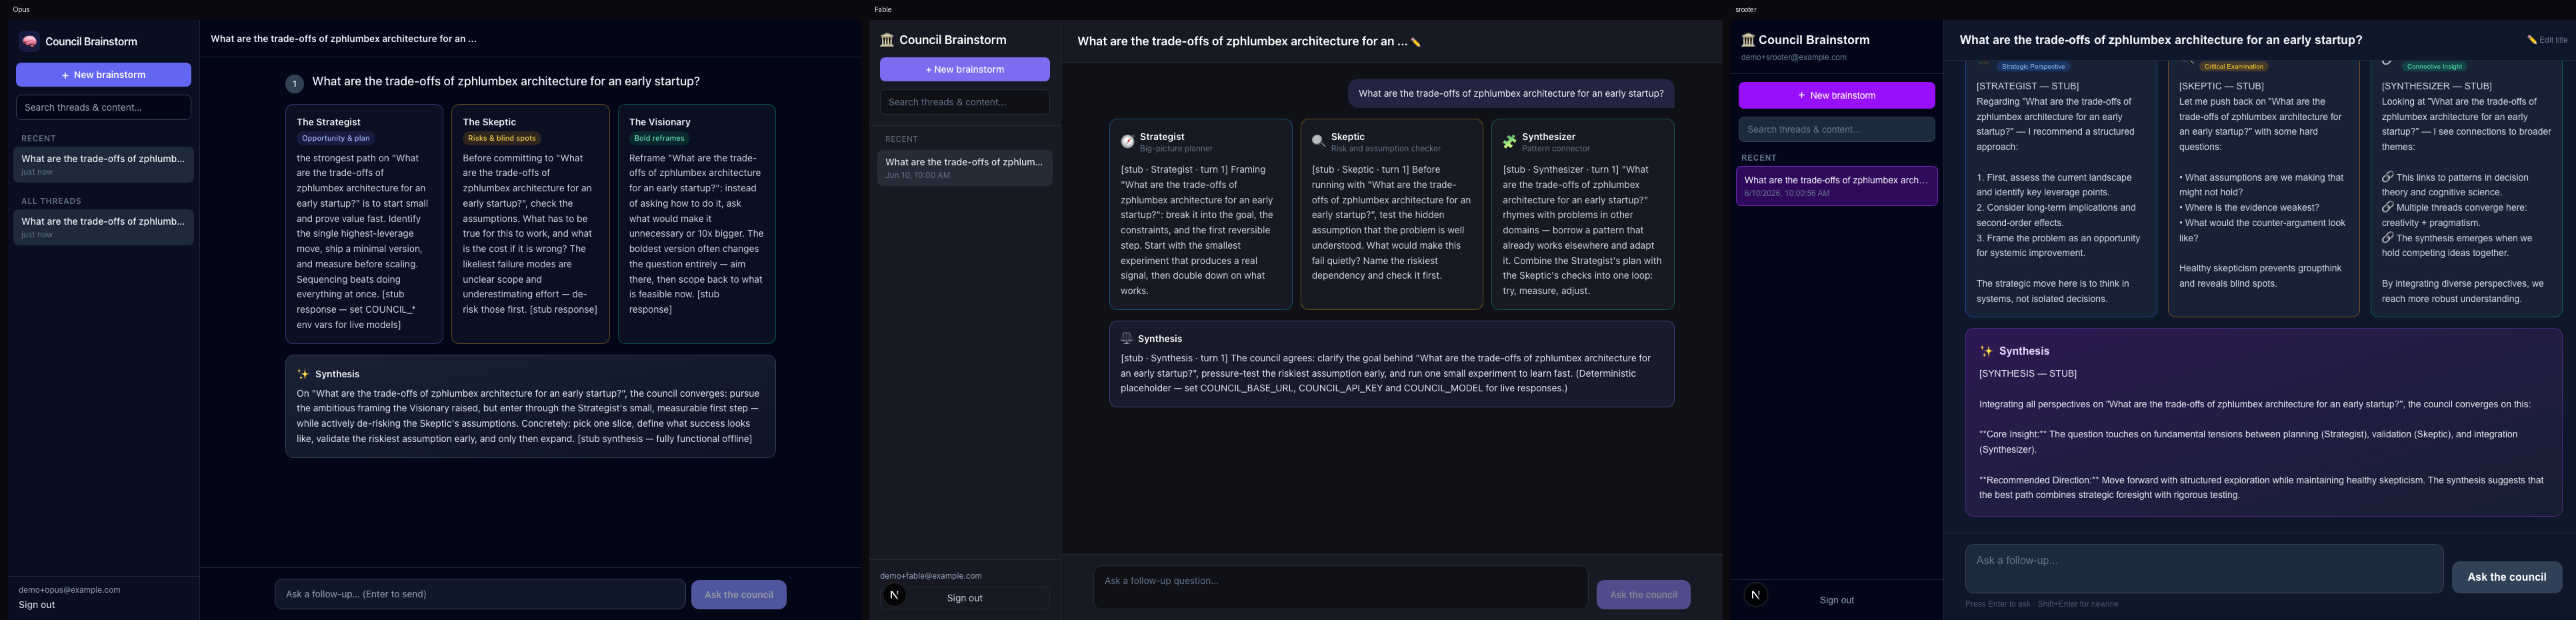
Die aktuelle Frontier-Klasse — gemini-3.7-flash, glm-5.3, kimi-k3, claude-fable-5.1, gpt-5.6-terra, gpt-6-astra — baute über den Palgu-Agenten jeweils DIESELBE vollständige App (Council Brainstorm: E-Mail-Login, ein Gremium aus drei Teilnehmern + Synthese, persistente durchsuchbare Threads), exakt fixiert und unverändert ausgeführt. Bewertet anhand von 8 Playwright-Akzeptanztests + Screenshots. Alle sechs lieferten eine funktionierende 8/8-App; entscheidend sind hier also Kosten und Geschwindigkeit, nicht Bestanden/Nicht-bestanden. Kosten = Tokens × Listenpreis für einen Build.
Modell
Abnahme
Laufzeit
Kosten / Build
Qualität (UI)
Hinweise
gemini-3.7-flashGoogle
8/8
689s
$0.46
Durchdachte dunkle UI, kontextsensitiver Composer
Günstigstes der sechs: sauberer Build in einer Iteration; bestes Preis-Leistungs-Verhältnis
glm-5.3Z.ai
8/8
780s
$1.19
Sanftes helles Theme, Turn-Marker
8/8 im ersten Versuch – Palgus eigener günstiger Standard hält gegen die Frontier-Modelle stand
kimi-k3Moonshot
8/8
667s
$1.83
Dunkles Theme, Fragen-Layout mit Sprechblasen
Günstig und schnell; sauberer Build
claude-fable-5.1Anthropic
8/8
386s
$5.91
Helles Theme, farbcodierte Rollenkarten
Schnellster Build der sechs (386 s), eine Iteration
gpt-5.6-terraOpenAI
8/8
2581s
$6.07
Umfangreichste dunkle UI, Emoji-Rollen-Badges
Hohe Varianz: erster Build DEFEKT ausgeliefert (Laufzeit-SQLite-Bug, 1/8); der zweite Durchlauf bestand mit 8/8, war aber am langsamsten (43 Min.)
gpt-6-astraOpenAI
8/8
1074s
$26.52
Umfangreichste Metadaten + Gradient-Branding
NEUESTES + teuerstes – gleiche 8/8 für das 58-Fache der Kosten von gemini; verbrennt 2,35M Input-Token beim Abwägen, kein Qualitätsvorsprung
Alle sechs lieferten eine funktionierende, ausgereifte 8/8-App; bei der Qualität herrscht faktisch Gleichstand. Jeder Build umfasst den Login, die drei nach Rollen benannten Council-Karten, die Synthese, die Suche und die Persistenz. „Welches Modell ist intelligent genug?“ ist heute die falsche Frage. Sie sind es alle.
Die eigentliche Spannweite liegt bei den Kosten: Faktor 58× zwischen dem günstigsten und dem teuersten Modell für ein identisches Ergebnis. gemini-3.7-flash baut die App für $0.46; gpt-6-astra kostet $26.52. Die Rechnung wird von Input-Tokens dominiert (Kontext, der über bis zu 90 Agenten-Turns hinweg immer wieder mitgesendet wird), und Astra verbrennt 2,35 Mio. davon durch langes Abwägen – ohne jeden Qualitätsvorteil.
Ein einzelner grüner Durchlauf bedeutet noch keine Zuverlässigkeit. gpt-5.6-terra lieferte zunächst einen fehlerhaften Build: Er kompilierte zwar, aber die Login-Route stürzte zur Laufzeit ab (SQLITE_ERROR), was zu 1/8 führte. Ein erneuter Durchlauf bestand mit 8/8, dauerte jedoch 43 Minuten. Nehmen Sie die Varianz zwischen Durchläufen ernst.
Fazit
Beim agentischen Coding ist die Spitze dicht besetzt und die meisten Modelle können die Arbeit erledigen. Zum neuesten, teuersten Modell zu greifen, ist keine Qualitätsentscheidung mehr, sondern die Entscheidung, das Dutzendfache für dasselbe Ergebnis zu zahlen. Genau diese Wahl pro Anfrage, also das günstigste Modell, das Ihren Anspruch erfüllt, übernimmt das Routing von Palgu.
Methodik. Jedes Modell hat dieselbe SPEC mit dem Palgu-Agenten über das Gateway gebaut, fixiert (x-srooter-pin), sodass der Router es direkt ohne Routing angesprochen hat; Iterate-to-Pass war auf 3 Runden mit einem Zeitlimit von 30 Min. pro Iteration begrenzt. Genauigkeit = 8 Playwright-Checks (A1–A8) gegen den PRODUCTION-Build, nicht den Dev-Build. Kosten = Token × Listenpreis-Schätzung (der exakte Wert sind die Audit-Kosten des Gateways). Qualität bewertet anhand von Screenshots mit identischem Viewport. Ein einzelner Build pro Modell (terra wurde nach einem Build mit Laufzeitfehler einmal neu ausgeführt). September 2026.
Gemessen · Flagship-Default-A/B
verifiziert August 2026 · bewertet nach Preis 50 % · Qualität 30 % · Geschwindigkeit 20 %
Personal-CFO-Build — welches Modell sollte der Standard sein?
Eine Spezifikation, drei Modelle, derselbe Harness (der Palgu-Agent, gepinnt, Iteration bis zum Bestehen): eine Personal-CFO-App – E-Mail-Login, Einnahmen-/Ausgaben-Tracking und ein dialogorientierter CFO, der „Kann ich mir das leisten?“ mit einem fundierten, maschinell prüfbaren Urteil beantwortet. Jedes Modell lieferte eine funktionierende 8/8-App; das Ranking basiert daher auf dem Preis×Qualität×Geschwindigkeit-Score des Betreibers, nicht auf Bestanden/Durchgefallen. Die Kosten entsprechen den Token bis zur ersten 8/8 × Listenpreis.
Modell
Abnahme
Iter.
Kosten
Laufzeit
Bewertung
Hinweise
glm-5.3Z.ai
8/8
1
$1.71
19 min
0.896
NEUER Standard (ADR-079) – am günstigsten UND 8/8 im ersten Versuch; gewinnt die Gewichtung
kimi-k3Moonshot
8/8
1
$2.18
9 min
0.893
Geschwindigkeits-Champion (2× schneller), aber ~5,5× höherer Preis pro Token → insgesamt teurer
glm-5.2Z.ai
8/8
2
$1.72
25 min
0.871
Bisheriger Standard — benötigte eine 2. Iteration; glm-5.3 schlägt ihn im ersten Anlauf
Alle drei liefern eine funktionierende 8/8-App; daher entscheidet die Punktzahl, nicht Bestanden/Nicht bestanden. Unter der Betreibergewichtung Preis 50 / Qualität 30 / Tempo 20 liegen alle drei innerhalb von ~2,5 Punkten: gleichauf, mit glm-5.3 leicht vorn.
glm-5.3 ist der neue Standard (ADR-079): Es ist das günstigste der drei UND schaffte den Build auf Anhieb in einer einzigen Iteration, während glm-5.2 zwei benötigte. Dies ist der direkte Test, der den Wechsel bestätigt hat – glm-5.3 schlägt das ersetzte Modell messbar.
Geschwindigkeit hat ihren Preis: kimi-k3 baut 2× schneller (9 vs. 19 Min.), kostet aber ~5,5× so viel pro Token und ist damit insgesamt teurer. Routing auf Geschwindigkeit → kimi-k3; auf Kosten pro ausgeliefertem Build → glm-5.3.
Hinweis. Ein Durchlauf pro Modell (n=1). Die Token-Zahlen schwanken von Lauf zu Lauf; lesen Sie das Ergebnis daher als „gleichauf, glm-5.3 leicht vorn“ und nicht als Erdrutschsieg. Für glm-5.3 wird bis zur Bestätigung des Flaggschiff-Listenpreises von Z.ai der Mischpreis von glm-5.2 ($0.0011/1k) angesetzt; da der Preis 50 % des Scores ausmacht, würde ein höherer tatsächlicher Preis den Abstand verringern.
Methodik. Derselbe Agent-Build-Harness wie in der Juli-Studie, auf der isolierten Benchmark-Organisation: der Palgu-Agent fixiert über x-srooter-pin, sodass das Gateway jedes Modell direkt angesprochen hat; Iterate-to-Pass gegen eine 8-Punkte-Playwright-Akzeptanz-Suite (Login → Einnahmen → Ausgaben → Monatsübersicht → Leistbarkeits-Bewertung), mit Rundenlimit. Score = 0,5·Preis + 0,3·Qualität + 0,2·Geschwindigkeit, jeweils normiert auf den besten Durchlauf; Kosten = Token bis zum ersten 8/8-Ergebnis × Listenpreis der Konfiguration. August 2026.
Gemessen · Agent-Build-Benchmark
verifiziert Juli 2026
Coding-Build-Off mit neun Modellen
Ein Agent, eine vollständige App – E-Mail-Login, ein „Rat“ aus drei Diskussionsteilnehmern samt Synthese, persistente Threads und Volltextsuche. Zwei Achsen: (1) 8 Browser-Akzeptanztests (funktioniert es?), (2) eine manuell bewertete Feinschliff-Note von 0–5 für den fertigen Build (ist er gut?). Acht von neun bestanden alle 8 Checks; Bestanden/Durchgefallen reizt das Feld also nicht aus – der Feinschliff macht den Unterschied. Jedes Modell gepinnt (direkt angesprochen, ohne Routing); Iteration bis zum Bestehen, mit Obergrenze. Zeiten sind reale Laufzeit (Wall-Clock); Token sind Output. Zeilen sortiert nach Feinschliff, dann Effizienz.
Modell
Abnahme
Feinschliff
Build
Iter.
Laufzeit
Out-Token
Hinweise
kimi-k3
8/8
Bestanden
2
1208s
36.9k
NEU · Moonshot-Flaggschiff – 5/5 Feinschliff in den WENIGSTEN Iterationen (2); günstigste 5/5 nach Build-Kosten
Am schnellsten: 8/8 in einem Durchgang, aber schlichteres UI (rohes Markdown sichtbar)
kimi-2.7-code
8/8
Bestanden
3
772s
30.7k
Bestanden, aber die schlichteste Umsetzung — flache Karten, kein Rollendesign
Sechs von acht Modellen bauten eine funktionierende App mit perfekten 8/8 Punkten — ein reines Bestanden/Nicht-bestanden reicht für ein Ranking also nicht aus. Wir haben jeden fertigen Build manuell von 0–5 hinsichtlich Layout, Rollendesign und Fehlertoleranz (Graceful Degradation) bewertet. Genau hier zeigt sich der wahre Unterschied.
Der Feinschliff folgt der Modellklasse: Opus, Fable und Sol lieferten 5/5-Builds (farbcodierte Rollen der Diskussionsteilnehmer, saubere Fallbacks bei fehlendem API-Key); DeepSeek und Kimi bestanden dieselben Tests, lieferten aber deutlich schlichtere UIs (3/5, 2/5). Die 8/8-Obergrenze der Tests verdeckte genau diesen Unterschied.
Der Preis-Leistungs-Sieger ist neu: Kimi K3 erreicht dieselben 5/5 beim Feinschliff wie Opus / Fable / Sol, aber für ~$3.60 / Build – halb so teuer wie Opus, ein Drittel von Fable – und schaffte 8/8 in den wenigsten Iterationen (2). Der einzige Kompromiss ist die Geschwindigkeit (1208s; das Flaggschiff mit maximalem Reasoning ist langsamer als Opus mit 652s). Kein einzelner Gewinner: Routen Sie anspruchsvolle Aufgaben, bei denen Qualität zählt, zu K3 (günstigste 5/5) oder Opus (schnellste 5/5), und hohes Volumen zu schnell-und-gut-genug (DeepSeek / GPT-5.5).
Methodik. Ein eigenständiger Durchlauf im Juli 2026 mit neun Modellen inkl. Kimi K3 (gegenüber dem „Fünf Modelle“-Block vom Juni weiter unten) auf einem verbesserten Harness: Empty-Turn-Failover und Tool-Loop-Fixes haben den GPT-5.5-Build-Fehler aus dem Juni behoben, ergänzt durch einen Watchdog pro Iteration und eine Port-Bereinigung. Jedes Modell war fixiert (direkt ausgeliefert, ohne Routing); Iterate-to-Pass war auf 5 Runden begrenzt; Zeiten sind Echtzeit (Wall-Clock), Token sind Output-Token. Der Feinschliff-Score (0–5) ist eine subjektive, manuelle Bewertung jedes fertigen Builds (Layout, Gestaltung der Panelisten-Rollen und stabiles Verhalten bei fehlender Konfiguration) anhand von Screenshots mit identischem Viewport und des Quellcodes, keine automatisierte Metrik. Die Akzeptanz variiert von Lauf zu Lauf bei der kosmetischen Prüfung der Panelisten-Anzahl (weshalb Opus und GLM-5.2 in einem Lauf 7/8 und in einem anderen 8/8 erreichen können). Dies sind die Zahlen dieses Durchlaufs; sie ersetzen nicht den separaten Juni-Block.
Die Preisperspektive · Kosten für den Bau derselben App
Die Preisperspektive — was Feinschliff kostet
Dieselbe App, Baukosten pro Modell zum Listenpreis (konstant ~1 Mio. Input- + 40k Output-Tokens — der Durchschnitt im Vergleichstest). Die Punkte zeigen den manuell bewerteten Feinschliff. Die Frage, die ein Router pro Anfrage beantwortet: Welches ist das günstigste Modell, das Ihre Qualitätsanforderungen erfüllt?
Modell
Feinschliff
Build-Kosten →
Liste · In / Out pro 1M
deepseek-proGünstigstes, das liefert
$0.47
$0.44 / $0.87
glm-5.2Bestes Preis-Leistungs-Verhältnis (4/5)
$1.14
$1.10 gemischt
gpt-5.6-lunaKostentarif (nicht gebaut)
k. A.
$1.24
$1.00 / $6.00
kimi-2.7-codeTeurer für weniger Leistung
$1.77
$1.70 gemischt
gpt-5.6-terraAusgewogen
$3.10
$2.50 / $15.00
kimi-k3Günstigstes 5/5 · Flaggschiff
$3.60
$3.00 / $15.00
claude-opusSchnellstes 5/5
$6.00
$5.00 / $25.00
gpt-5.6-solFrontier-Spitze · 3–4× langsamer
$6.20
$5.00 / $30.00
gpt-5.5Flaggschiff-Preis, 4/5 Build
$6.20
$5.00 / $30.00
claude-fable-5Premium 5/5
$12.00
$10.00 / $50.00
5/5 Handwerkskunst gefragt
kimi-k3
$3.60 / Build — günstigstes 5-Sterne-Modell, erreicht den Feinschliff von Opus/Fable (Opus ist mit $6.00 schneller)
Solide 4/5, günstig
glm-5.2
$1.14 / Build — 5× günstiger als ein Flaggschiff, eine Stufe weniger Feinschliff
Muss einfach funktionieren
deepseek-pro
$0.47 / Build — liefert 8/8 in einem Durchlauf, schlichteres UI
Kimi K3 hat die Spitzenklasse neu definiert: derselbe 5/5-Feinschliff wie Opus / Fable / Sol für $3.60 pro Build und damit das günstigste 5-Sterne-Modell der neun (halb so teuer wie Opus, ein Drittel von Fable). Die anderen Flaggschiffe bilden eine Preisklasse für einen langsameren oder teureren Weg zum gleichen Niveau: gpt-5.6-sol kostet genauso viel wie Opus, läuft aber 3–4× langsamer; gpt-5.5 verlangt Flaggschiff-Preise für einen 4/5-Build. Wählen Sie das günstigste Modell, das Ihren Anspruch erfüllt. Dieses Routing pro Anfrage ist Palgu.
Listenpreis, ungecacht. Echte agentische Builds cachen das Input-Präfix (~10× günstiger im Input), sodass die absoluten Kosten in $ niedriger ausfallen – die Reihenfolge bleibt jedoch bestehen. GLM & Kimi werden zum kombinierten Konfigurationspreis des Gateways ausgewiesen (keine öffentliche In/Out-Aufteilung).
Gemessen · First-Party-Benchmark
verifiziert Juni 2026
Vollständiger App-Build im ersten Versuch
Bau einer kompletten App in einem einzigen autonomen Durchlauf: E-Mail-Login, ein multiperspektivisches „Council“ mit Antworten von drei Panelisten samt Synthese, persistente Threads und Volltextsuche. Gleiche Spezifikation, gleicher Harness; gemessen nach Qualität, Kosten und Tempo.
Metrik
Claude Opus 4.8 (direkt)
Claude Fable-5 (direkt)
Palgu (gesteuertes Routing)
Abnahmekriterien (Browser-E2E)
8/8
8/8
8/8
Typprüfungen & Builds (npm run build)
Bestanden
Bestanden
Bestanden
Build-Kosten (gemessen)
$3.02
$3.05
≈$1–3
Reale Laufzeit
7.96 min
5.95 min
10–16 min
Verarbeitete Token
2.43M
1.06M
3.6–4.5M
Agenten-Züge
43
39
53–66
UX-Feinschliff (geprüft anhand von Screenshots)
4.5/5
5/5 ★
4/5
Der Preis pro Token ist die falsche Kennzahl: Fable-5 kostet pro Token zwar ~2× so viel wie Opus, verbraucht aber ~2,3× weniger Tokens — identische Gesamtkosten (~$3), aber 25 % schneller. Optimieren Sie auf Tokens bis zum fertigen Ergebnis.
Palgu lieferte durch gesteuertes Routing auf günstige Modelle dieselbe 8/8-App mit erfolgreichem Build zu etwa der Hälfte bis einem Drittel der direkten Frontier-Kosten – und tauschte dabei reine Laufzeit gegen Kosteneffizienz + Governance (Budgets, Audit, Richtlinien).
Die Palgu-Kosten werden im Gateway-Audit gemessen: Client-seitige Zähler berechnen geroutete Backends zu den Tarifen des angeforderten Modells und können die tatsächlichen Ausgaben um das 5- bis 10-Fache zu hoch ausweisen.
Dieselbe App, auf drei Arten autonom erstellt (links → rechts: Opus 4.8 · Fable-5 · Palgu). Alle drei: 8/8 Akzeptanzkriterien, saubere typgeprüfte Builds.
Claude Fable-5 vs. Opus 4.8: Die Bilanz zur Token-Effizienz
Preis pro Token
Fable-5 ≈ 2,0× Opus ($10/$50 vs. $5/$25 pro Mio. In/Out)
Token bis zur Fertigstellung derselben App
1.06M vs. 2.43M — Fable benötigte 2.3× weniger
Endergebnis
Gesamtkosten innerhalb von 1 % (jeweils ~$3) · Fable 25 % schneller (5,95 vs. 7,96 Min.) · weniger Turns (39 vs. 43)
Qualität
Beide 8/8 im echten Browser; Fable lieferte die ausgereifteste UI der drei Builds (nach Rollen benannte Panelisten-Karten, klarste Hierarchie)
Ein stärkeres Modell, das die Aufgabe auf Anhieb in weniger Zügen löst, kann günstiger UND schneller sein als ein vermeintlich „billigeres“ Modell, das mehr Versuche benötigt. Genau nach diesem Signal entscheidet das Routing von Palgu: Tokens bis zum fertigen Ergebnis, nicht der Listenpreis pro Token.
Methodik. Eine Spezifikation, ein Harness: Jede Konfiguration erhielt einen einzigen autonomen `claude -p`-Durchlauf (keine Wiederholungen, keine menschliche Hilfe) gegen dieselbe schriftliche Spezifikation mit 8 Akzeptanzkriterien. Die Qualität wurde durch einen Headless-Playwright-E2E-Test, der jedes Kriterium in einem echten Browser prüfte, sowie `npm run build` verifiziert; Kosten und Token stammen aus den Lauf-Artefakten und dem Gateway-Audit; die UX wurde anhand von Screenshots mit identischem Viewport bewertet. Juni 2026.
Gemessen · Multi-Modell-Benchmark
verifiziert Juni 2026
Fünf Modelle, dieselbe App: Coding- und Routing-Stufen
Jedes Modell hat über den Palgu-Agenten (unsere eigene CLI) dieselbe App aus Next.js 15 + TypeScript + Tailwind („Council Brainstorm“) End-to-End erstellt und so lange iteriert, bis eine 8-teilige Playwright-Abnahmesuite bestanden wurde (maximal 4 Runden). Die Modelle waren fixiert, sodass das Gateway jedes unverändert auslieferte. Bewertet wurden Genauigkeit, Geschwindigkeit, Output-Tokens, Kosten und UI-Feinschliff.
Schwergewichtig: ein Coding-Modell, kein Routing-Modell
Kein einzelnes „bestes“ Modell: GLM-5.2 gewann bei der Build-Qualität (einzige 8/8 mit der saubersten UI), DeepSeek-V4 Pro beim Preis-Leistungs-Verhältnis (ebenfalls 8/8, 2,9× schneller, niedrigste Kosten), Cerebras gewann die Routing-Stufe bei der Geschwindigkeit. Genau diese Spreizung ist der Grund, warum eine Routing-Schicht existiert.
Das günstigere Modell gewann auf ganzer Linie: GLM-5.2 baute dieselbe App und schnitt besser ab als Claude Opus (8/8 vs. 7/8) — zu einem Bruchteil der Kosten. Direkt verglichen (die Input-Tokens von GLM wurden nicht erfasst, die $0.12 beziehen sich also nur auf den Output) ist das ~25× günstiger als Opus mit ≈$25.73; betrachtet man nur die Output-Tokens, ist der Abstand noch weitaus größer. Der reine Listenpreis pro Token ist die falsche Kennzahl.
GPT-5.5 scheiterte über unseren konvertierten Bereitstellungspfad (leere Antworten); da das Modell fixiert war, war das Failover des Gateways für leere Antworten deaktiviert, sodass der Fehler ungefiltert durchschlug. Lassen Sie das Failover dafür aktiviert. Ein echter Zuverlässigkeitsbefund, kein Abrechnungsfehler.
Methodik. Komplett auf unserem eigenen Stack ausgeführt: Palgu Gateway + Palgu Agent CLI (Dogfooding). Genauigkeit geprüft via Playwright (8 Akzeptanzkriterien); UI-Feinschliff bewertet anhand von Screenshots mit identischem Viewport. Die Kosten basieren auf dem Listenpreis pro Token (der exakte Wert stammt aus dem Gateway-Audit); bei einigen Modellen wurden die Input-Token vom Client nicht erfasst, sodass deren Kosten nur den Output umfassen und zu niedrig ausgewiesen sind. Vergleichen Sie daher die Größenordnung, nicht auf den Cent genau. Modelle wurden über x-srooter-pin fixiert, sodass jedes direkt statt über das Routing angesprochen wurde. Juni 2026.
Anwendungsfall × Modell-Eignung
Anwendungsfall
Claude Opus4.8
GLM5.3
MiniMax-M2M2
MiniMax-M3M3
Gemini3.1 Pro
DeepSeekV3.2
Cerebrasgpt-oss-120b
Qwen332B
Coding-Agent
geroutet
Gesamtes Repo / langer Kontext
geroutet
Architektur- & Sicherheits-Review
geroutet
Schnelle Edits & Routinearbeiten
geroutet
Massenextraktion & -klassifizierung
geroutet
Komplexes Debugging & Reasoning
geroutet
Beste Wahl Stark OK Palgu routet hierhin
Modellreferenz
Die Modelle, zwischen denen Palgu routet – inklusive Versionen und den jeweiligen Stärken. Die Werte für SWE-bench Verified stammen aus externen Quellen (Richtwerte, siehe Hinweis).
Claude Opus4.8
Anthropic
Frontier-Coding, Architektur- und Sicherheitsurteil
Kontext:
200K (1M Beta)
SWE-bench:
~88.6%
GLM5.3
Z.ai
Palgus Standard für anspruchsvolles Coding (ADR-079) — höchste Build-Qualität zu einem Bruchteil der Frontier-Kosten
Kontext:
~200K
SWE-bench:
Eigener Test: 8/8-Build; gewinnt den Standard-A/B-Test (Aug. 2026)
MiniMax-M2M2
MiniMax
Coding fast auf Frontier-Niveau zu einem Bruchteil der Kosten
Kontext:
~205K
SWE-bench:
~80 % (Open-Weight-Spitzenreiter)
MiniMax-M3M3
MiniMax
Arbeit über das gesamte Repository / mit langem Kontext ohne Abschneiden
Kontext:
1M
SWE-bench:
—
Gemini3.1 Pro
Google
Multimodal, Massenextraktion, fundierte Recherche
Kontext:
1M+
SWE-bench:
~80.6%
DeepSeekV3.2
DeepSeek
Starkes Reasoning & Debugging, sehr geringe Kosten
Kontext:
128K
SWE-bench:
~73%
Cerebrasgpt-oss-120b
Cerebras
Palgus Standard für einfache Aufgaben — schnellste bezahlte Inferenz für Commits & Routinearbeiten
Kontext:
128K
SWE-bench:
—
Qwen332B
Alibaba
Lokaler/günstiger Fallback für triviale Turns
Kontext:
256K
SWE-bench:
—
Externe Benchmarks werden als Belege mit Quelle und Datum angegeben (geprüft im Juni 2026); betrachten Sie diese als Richtwerte. SWE-bench Verified ist bekanntermaßen teilweise kontaminiert (OpenAI wechselte Anfang 2026 zu SWE-bench Pro), weshalb bei uns die Eignung für den Anwendungsfall an erster Stelle steht und nicht eine einzelne Kennzahl. Die Eignungsbewertungen sind Routing-Empfehlungen von Palgu, keine gemessenen Punktzahlen.