「多数のファイルにまたがる機能の実装やリファクタリング」
コーディングエージェント
日常的な複数ファイルのコーディングは、Palguの実質的なデフォルト(ADR-079)であるGLM-5.3にルーティングされます。このモデルは自社のデフォルトA/Bテストで勝利し、テストした3つのモデルの中で最も低いコストで、8/8項目をクリアする動作アプリをワンショットで構築しました。最も重要度の高い作業はClaude Opusと評議会にエスカレーションされます。また、リクエストごとに任意のモデルを固定することも可能です。予算だけを理由にコーディングのターンを密かにダウングレードすることは決してありません。
生産性の成果
初回PRの正確性、レビューの往復を削減
エビデンス · 自社デフォルトA/Bテスト
GLM-5.3 ワンショットで8/8合格 · kimi-k3およびGLM-5.2との価格×品質×速度スコアで勝利 · ブラウザ検証済み
Palgu ベンチマーク ↗2026年9月検証済み
6つのフロンティアモデルで同じアプリをビルド
現在のフロンティア層であるgemini-3.7-flash、glm-5.3、kimi-k3、claude-fable-5.1、gpt-5.6-terra、gpt-6-astraの各モデルを固定してそのまま使用し、Palguエージェントを通じてまったく同じフルアプリ(Council Brainstorm:メールログイン、3人のパネリストによる合議と統合、永続化された検索可能なスレッド)をビルドしました。8つのPlaywright受け入れチェックとスクリーンショットで採点した結果、6モデルすべてが8/8満点の動作するアプリを完成させたため、焦点は合否ではなくコストと速度になります。コスト = 1ビルドあたりのトークン数 × 定価。
| モデル | 受け入れ判定 | 実時間 | コスト / ビルド | 品質(UI) | 備考 |
|---|
| gemini-3.7-flashGoogle | 8/8 | 689s | $0.46 | 洗練されたダークUI、コンテキスト認識コンポーザー | 6モデル中で最安。1イテレーションでクリーンにビルド完了し、最高のコストパフォーマンス |
| glm-5.3Z.ai | 8/8 | 780s | $1.19 | ソフトなライトテーマ、ターンマーカー | ワンショットで8/8達成 · Palgu独自の低コストなデフォルト設定がフロンティアモデルに匹敵 |
| kimi-k3Moonshot | 8/8 | 667s | $1.83 | ダークテーマ、チャットバブル形式の質問レイアウト | 低コストかつ高速、クリーンなビルド |
| claude-fable-5.1Anthropic | 8/8 | 386s | $5.91 | ライトテーマ、色分けされたロールカード | 6モデル中で最速のビルド(386秒)、単一イテレーション |
| gpt-5.6-terraOpenAI | 8/8 | 2581s | $6.07 | 最もリッチなダークUI、絵文字のロールバッジ | ばらつきが大: 初回ビルドは破損状態で出荷(実行時SQLiteバグ、1/8)。再実行で8/8に合格したものの最遅(43分) |
| gpt-6-astraOpenAI | 8/8 | 1074s | $26.52 | 最もリッチなメタデータ+グラデーションのブランディング | 最新・最高額 · geminiの58倍のコストで同じ8/8、推考に2.35M入力トークンを消費し品質面の優位性なし |
6モデルすべてが 8/8 を満たす実用的な洗練されたアプリを出荷し、品質面では事実上横並びとなりました。どのビルドもログイン、役割ラベル付きの3枚の評議会カード、統合回答、検索、永続化を備えています。「どのモデルなら十分賢いか」という問いはもはや的外れであり、すべてが十分な水準に達しています。
本当の差はコストにあります。同じ結果を得るのに、最安モデルと最高額モデルで58倍の開きが出ました。gemini-3.7-flashが$0.46でビルドしたのに対し、gpt-6-astraは$26.52かかりました。請求額の大半を占めるのは入力トークン(最大90回のエージェントターンにわたって再送信されるコンテキスト)であり、Astraは品質面での優位性がないまま、熟考のために2.35Mトークンを消費しています。
1回成功したからといって信頼できるとは限りません。gpt-5.6-terra は初回に壊れたビルドを出荷しました。コンパイルは通ったものの、ログインルートが実行時にクラッシュ(SQLITE_ERROR)し、スコアは 1/8 でした。再実行では 8/8 を達成しましたが、43分かかりました。実行ごとのばらつきは現実の問題として捉える必要があります。
結論エージェンティックなコーディングにおいて、フロンティアモデルの選択肢は豊富であり、ほとんどのモデルが作業をこなせます。最新で最も高価なモデルに手を伸ばすことは、もはや品質のための判断ではなく、同じ結果に対して数十倍もの費用を払うという判断に過ぎません。求める基準をクリアする最も安価なモデルをリクエストごとに選択すること、それこそがPalguのルーティングです。
測定方法。 各モデルは、ゲートウェイ経由でPalguエージェントを通じて同一のSPECをビルドしました。ルーターがそのままモデルを提供するようピン留め(x-srooter-pin)し、合格までの反復は最大3ラウンド、1反復あたりの実経過時間は最大30分に制限しました。精度は、開発ビルドではなく本番(PRODUCTION)ビルドに対して実行された8つのPlaywrightチェック(A1〜A8)で測定しています。コストは「トークン数 × 定価」の推計値です(より正確な数値はゲートウェイの監査コストとなります)。品質は同一ビューポートのスクリーンショットから判定しました。モデルごとに1回ビルドを実施しています(terraはランタイムバグのあるビルド後に1回再サンプリングしました)。2026年9月。
実測 · フラッグシップデフォルト A/B2026年8月検証済み · スコア配分: 価格 50% · 品質 30% · 速度 20%
Personal CFOアプリのビルド:どのモデルをデフォルトにすべきか?
1つの仕様、3つのモデル、同じハーネス(Palguエージェント、モデル固定、合格までイテレーション)でパーソナルCFOアプリを構築。メールログイン、収支トラッキング、そして「これを買う余裕はあるか?」に根拠ある機械検証可能な判定で答える対話型CFOを備えます。すべてのモデルが8/8で動作するアプリを完成させたため、順位は合否ではなく、運用者の「価格×品質×速度」スコアで決まります。コストは最初の8/8達成までのトークン数×定価です。
| モデル | 受け入れ判定 | 反復数 | コスト | 実時間 | スコア | 備考 |
|---|
| glm-5.3Z.ai | 8/8 | 1 | $1.71 | 19分 | 0.896 | 新デフォルト (ADR-079) · 最安かつワンショットで8/8達成、総合評価で首位 |
| kimi-k3Moonshot | 8/8 | 1 | $2.18 | 9 min | 0.893 | スピード王者(2倍高速)だが、トークン単価が約5.5倍 → 総コストは割高に |
| glm-5.2Z.ai | 8/8 | 2 | $1.72 | 25分 | 0.871 | 以前のデフォルト:2回目のイテレーションが必要。glm-5.3がワンショットで凌駕 |
3モデルすべてが 8/8 を満たす動作するアプリを出荷したため、合否ではなくスコアが決め手となります。運用者の重み付け(価格 50 / 品質 30 / 速度 20)では、3モデルは約2.5ポイント差に収まりほぼ同率ですが、glm-5.3 がわずかにリードしています。
glm-5.3が新しいデフォルトとなりました(ADR-079)。3つの中で最安でありながら、glm-5.2が2回の反復を要したビルドを1回の反復(ワンショット)で完了させました。これは移行を裏付ける直接的なテスト結果であり、glm-5.3は置き換え前のモデルを明確に上回っています。
速度にタダ乗りはできません。kimi-k3は2倍高速にビルドしますが(9分 対 19分)、トークン単価が約5.5倍高いため、全体のコストは高くなります。速度重視のルーティングならkimi-k3、完成ビルドあたりのコスト重視ならglm-5.3を選択してください。
留意事項: 各モデル1回のみの実行(n=1)です。トークン数は実行ごとに変動するため、圧倒的な差ではなく「ほぼ同等、glm-5.3がわずかにリード」と解釈してください。Z.aiのフラッグシップモデルの定価が未確定のため、glm-5.3の価格はglm-5.2のブレンド単価($0.0011/1k)を仮適用しています。価格がスコアの50%を占めるため、実際の価格がこれより高ければ差は縮まります。
測定方法。 7月の調査と同じエージェントビルド・ハーネスを、隔離されたベンチマーク用組織上で使用しました。ゲートウェイが各モデルをそのまま提供するよう、Palguエージェントをx-srooter-pinでピン留めし、8項目のPlaywright受け入れテストスイート(ログイン → 収入 → 支出 → 月次サマリー → 支払い余力の判定)に対して上限付きで合格まで反復(iterate-to-pass)させました。スコアは「0.5 × 価格 + 0.3 × 品質 + 0.2 × 速度」で算出し、それぞれ最良の実行結果で正規化しています。コストは「最初の8/8達成までのトークン数 × 構成の定価」です。2026年8月。
実測 · エージェントビルドベンチマーク2026年7月検証済み
9モデルによるコーディングビルド対決
1つのエージェントで1つの完全なアプリ(メールログイン、3人のパネリストによる「評議会」と統合、永続スレッド、全文検索)を構築。評価軸は2つ:(1) 8項目のブラウザ受け入れテスト(動作するか?)、(2) 完成したビルドに対する手動採点の0〜5段階の完成度スコア(出来栄えは良いか?)。9モデル中8モデルが全8項目に合格したため、合否だけでは差がつかず、完成度が決め手となります。各モデルは固定(ルーティングせずそのまま提供)し、上限付きで合格するまでイテレーションを実施。時間は実経過時間、トークンは出力トークンです。行は完成度順、次に効率順で並んでいます。
| モデル | 受け入れ判定 | 完成度 | ビルド | 反復数 | 実時間 | 出力トークン | 備考 |
|---|
| kimi-k3 | 8/8 | | 合格 | 2 | 1208s | 36.9k | NEW · Moonshotフラッグシップ · 最少イテレーション(2回)で完成度5/5、ビルドコスト最安の5/5モデル |
| claude-opus | 8/8 | | 合格 | 3 | 652s | 40.8k | 5/5モデル中で最速(652秒)、最高の完成度、高速 |
| claude-fable-5 | 8/8 | | 合格 | 3 | 763s | 47.5k | 最高の完成度(ダークテーマ、役割のサブタイトル、丁寧なスタブ注記) |
| gpt-5.6-sol | 8/8 | | 合格 | 3 | 2196s | 73.3k | フロンティアのフラッグシップ: 最高の完成度、ただし3〜4倍低速 / 約2倍のトークン消費 |
| gpt-5.5 | 8/8 | | 合格 | 2 | 519s | 28.0k | 名前付きペルソナ+ロールタグ、クリーンなダークテーマ |
| glm-5.2 | 7/8 | | 合格 | 4 | 602s | 34.7k | 唯一の不合格はパネリスト数チェック、優れたダークテーマのビルド |
| gpt-5.6-terra | 8/8 | | 合格 | 2 | 1194s | 43.2k | GPT-5.6 バランス層(≈ GPT-5.5)、スタイル適用済みの設定バナー |
| deepseek-pro | 8/8 | | 合格 | 1 | 505s | 31.7k | 最速: 1パスで8/8合格、ただしUIは簡素(生のMarkdownが露出) |
| kimi-2.7-code | 8/8 | | 合格 | 3 | 772s | 30.7k | 合格だが最小限のビルド:フラットなカード、ロール別のデザインなし |
8モデル中6つが8/8満点で動作するアプリをビルドしたため、合否だけでは順位をつけられません。そこで、完成した各ビルドについて、レイアウト、ロール別のデザイン、適切なフォールバック(グレースフルデグラデーション)の観点から0〜5の手動採点を行いました。ここに本当の差が表れます。
完成度はモデルクラスに比例します。Opus、Fable、Solは5/5のビルド(色分けされたパネリストのロール、「APIキーなし」時の適切なフォールバック)を実装しました。一方、DeepSeekとKimiは同じチェックに合格したものの、より簡素なUI(3/5、2/5)にとどまりました。8/8という満点の上限によって、まさにこの差が隠れていたのです。
コストパフォーマンスのリーダーが交代しました。Kimi K3はOpus / Fable / Solと同じ5/5の完成度を達成しながら、コストは1ビルドあたり~$3.60(Opusの半分、Fableの3分の1)に抑え、最少の反復回数(2回)で8/8に到達しました。唯一のトレードオフは速度です(1208秒。推論特化のフラッグシップであるため、Opusの652秒より低速です)。単独の勝者はいません。品質が重視される高度な実装はK3(最安の5/5)またはOpus(最速の5/5)にルーティングし、大量処理は高速かつ十分な品質のモデル(DeepSeek / GPT-5.5)にルーティングするのが最適です。
測定方法。 2026年7月の個別実行です。改良されたハーネス上で、Kimi K3を含む9つのモデルを検証しました(下部の6月の「5モデル」ブロックとは異なります)。空ターンのフェイルオーバーとツールループの修正により、6月に発生したGPT-5.5のビルド失敗が解消され、反復ごとのウォッチドッグとポートのクリーンアップが追加されています。各モデルはピン留めされ(ルーティングされずそのまま提供)、合格までの反復(iterate-to-pass)は最大5ラウンドに制限しました。時間は実経過時間(ウォールクロック)、トークンは出力トークンです。0〜5の完成度スコアは自動指標ではなく、同一ビューポートのスクリーンショットとソースコードをもとに、完成した各ビルドのレイアウト、パネリストの役割設計、設定欠落時のグレースフルデグラデーションを主観的に手動採点したものです。受け入れテストの結果は、パネリスト数の外観チェックにおいて実行ごとに変動します(そのため、OpusやGLM-5.2はある実行で7/8、別の実行で8/8となる場合があります)。これらは今回の実行における数値であり、別個の6月のブロックを置き換えるものではありません。
価格の視点・同じアプリをビルドするコスト価格の視点・完成度にかかるコスト
同じアプリを各モデルの定価でビルドした際のコスト(入力約1M+出力40kトークンの一定条件、ビルド対決の平均値)。ドットは手動採点による完成度を示します。ルーターがリクエストごとに答えるべき問いは、「品質基準をクリアする最も安価なモデルはどれか」です。
| モデル | 完成度 | ビルドコスト → | 定価 · 入出力 / 1Mトークン |
|---|
| deepseek-pro出荷可能な最安モデル | | $0.47 | $0.44 / $0.87 |
| glm-5.24/5で最高のコスパ | | $1.14 | $1.10(ブレンド) |
| gpt-5.6-lunaコスト重視ティア(未ビルド) | n/a | $1.24 | $1.00 / $6.00 |
| kimi-2.7-code高コスト・低品質 | | $1.77 | $1.70(ブレンド) |
| gpt-5.6-terraバランス型 | | $3.10 | $2.50 / $15.00 |
| kimi-k3最安で5/5 · フラッグシップ | | $3.60 | $3.00 / $15.00 |
| claude-opus最速で5/5 | | $6.00 | $5.00 / $25.00 |
| gpt-5.6-sol最高峰の性能上限 · 3〜4倍低速 | | $6.20 | $5.00 / $30.00 |
| gpt-5.5フラッグシップ価格で4/5のビルド | | $6.20 | $5.00 / $30.00 |
| claude-fable-5プレミアムな5/5 | | $12.00 | $10.00 / $50.00 |
5/5の完成度が必要
kimi-k3
$3.60 / ビルド(最安の5つ星、Opus/Fableと同等の完成度。Opusは$6.00でより高速)
堅実な4/5、低コスト
glm-5.2
$1.14 / ビルド(フラッグシップの1/5のコスト、完成度は1段階下)
動作優先
deepseek-pro
$0.47 / ビルド(1パスで8/8を達成、シンプルなUI)
Kimi K3がトップ層を再定義しました。1ビルドあたり$3.60でOpus / Fable / Solと同じ5/5の完成度を実現し、9モデルの中で最も安価な5つ星モデルとなりました(Opusの半額、Fableの3分の1)。他のフラッグシップモデルは、同じ基準に到達するためにより遅いか高価な価格帯に位置しています。gpt-5.6-solはOpusと同等のコストでありながら実行速度が3〜4倍遅く、gpt-5.5は4/5のビルドに対してフラッグシップ料金を課しています。求める基準をクリアする最も安価なモデルを選ぶこと、それをリクエストごとにルーティングするのがPalguです。
定価、キャッシュなし。実際のエージェントによるビルドでは入力プレフィックスがキャッシュされるため(入力コストが約10分の1)、実際の金額はさらに低くなりますが、順位は変わりません。GLMとKimiはゲートウェイのブレンド設定レートで表示しています(公開されている入出力の別なし)。
実測 · ファーストパーティベンチマーク2026年6月検証済み
ワンショットでのフルアプリビルド
1回の自律実行で完全なアプリを構築します。要件は、メールログイン、3名のパネリストによる回答と統合回答を提示する多角的「評議会(council)」、スレッドの永続化、および全文検索です。同一の仕様とハーネスを用い、品質、コスト、速度を測定しました。
| メトリクス | Claude Opus 4.8(直接) | Claude Fable-5(直接) | Palgu(ガバナンス効いたルーティング) |
|---|
| 受け入れ基準(ブラウザ E2E) | 8/8 | 8/8 | 8/8 |
| 型チェックとビルド(npm run build) | 合格 | 合格 | 合格 |
| ビルドコスト(実測値) | $3.02 | $3.05 | ≈$1–3 |
| 実経過時間 | 7.96 min | 5.95 min | 10–16分 |
| 処理トークン数 | 2.43M | 1.06M | 3.6–4.5M |
| エージェントターン数 | 43 | 39 | 53–66 |
| UXの完成度(スクリーンショットからレビュー) | 4.5/5 | 5/5 ★ | 4/5 |
トークン単価は見るべき指標ではありません。Fable-5のトークン単価はOpusの約2倍ですが、消費トークン数は約2.3分の1に抑えられ、合計コストは同等(約$3)で25%高速に完了しました。完了までの総トークン数を最適化すべきです。
Palguは、ガバナンスの効いた低コストモデルのルーティングにより、フロンティアモデルを直接利用する場合の約半分から3分の1のコストで、同じ8/8のビルド合格アプリを実現しました。実経過時間と引き換えに、コスト削減とガバナンス(予算、監査、ポリシー)を両立しています。
Palguのコストはゲートウェイの監査ログで計測されます。クライアント側のメーターは、ルーティングされたバックエンドをリクエスト元モデルのレートで計算するため、実際の支出を5〜10倍過大に計上する可能性があります。
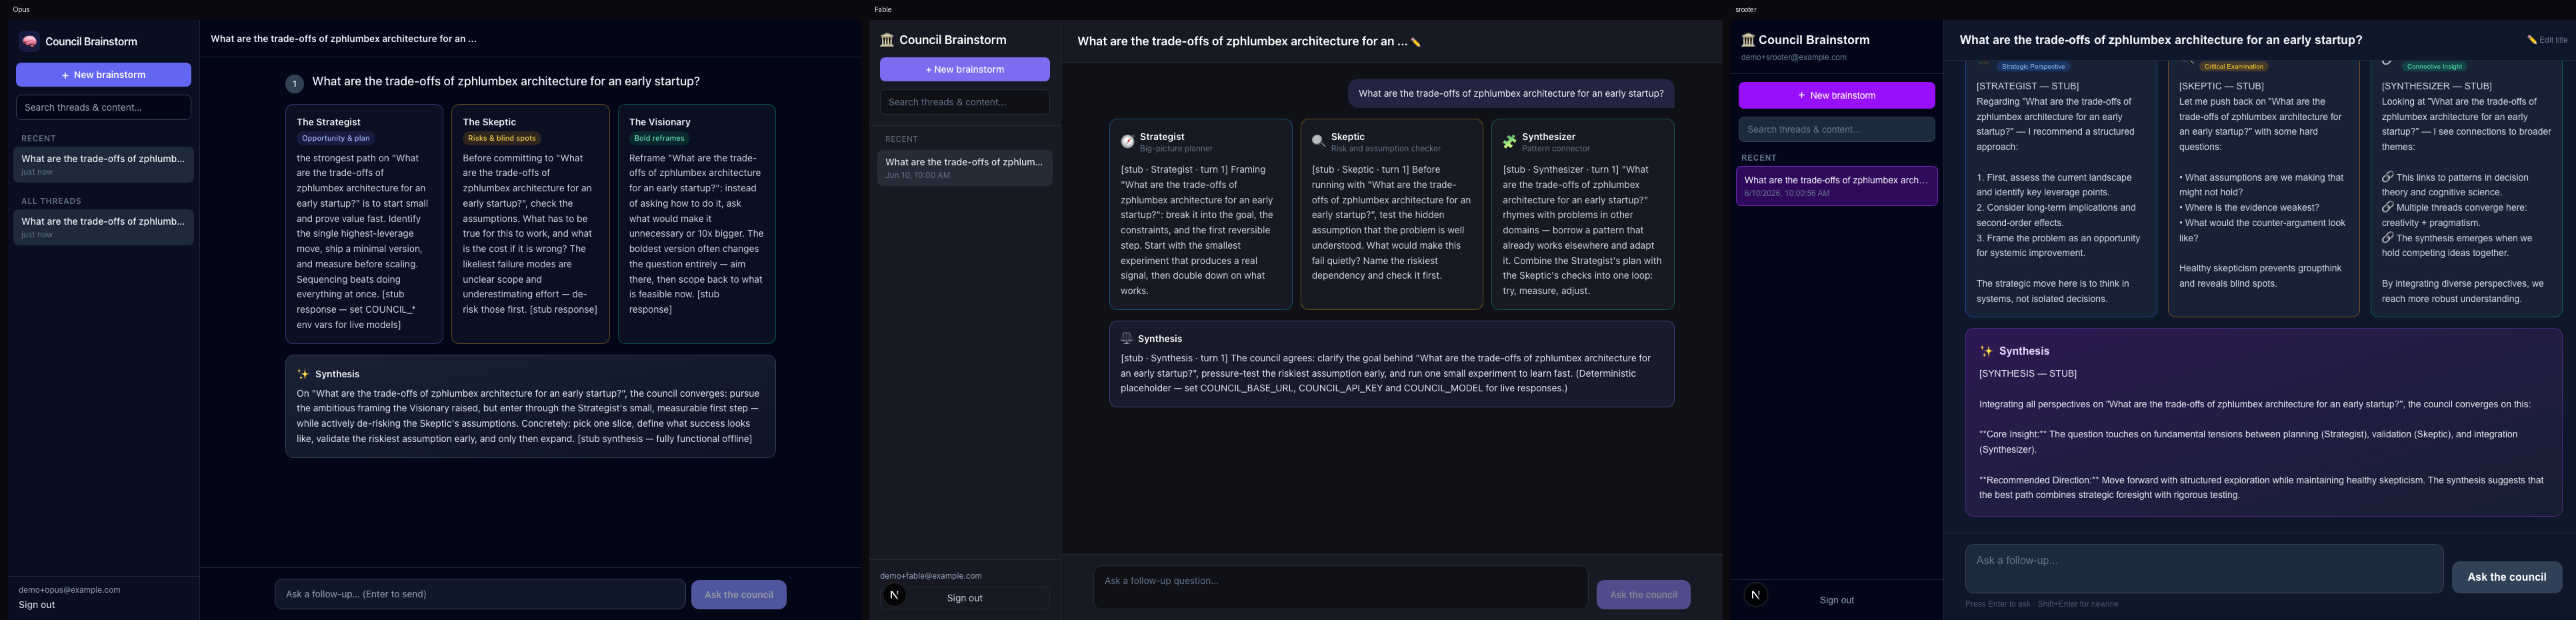 3つの方法で自律的に構築された同一のアプリ(左から右へ: Opus 4.8 · Fable-5 · Palgu)。3つすべてが8/8の受入基準を満たし、型チェック済みのクリーンなビルドを達成しています。
Claude Fable-5 vs Opus 4.8:トークン効率の比較
- トークン単価
- Fable-5 ≈ 2.0× Opus(1M 入力/出力あたり $10/$50 対 $5/$25)
- 同一アプリの完成までに要したトークン数
- 1.06M vs 2.43M(Fableは消費量が1/2.3)
- 最終結果
- 総コストの差は1%以内(各~$3) · Fableが25%高速(5.95分 対 7.96分) · ターン数が少ない(39 対 43)
- 品質
- どちらも実ブラウザで 8/8 を達成。Fable は3つのビルドの中で最も洗練された UI(役割ラベル付きのパネリストカード、最も整理された階層構造)を生成しました
少ないターン数で一発完了する高性能なモデルは、何度も試行を繰り返す「安価」なモデルよりも結果的に安く、かつ速く済むことがあります。これこそが Palgu のルーティング基準です。つまり、1トークンあたりの表示価格ではなく、完了までの総トークン数(tokens-to-done)に基づいています。
測定方法。 単一の仕様、単一のハーネス。各構成において、8つの受け入れ基準を持つ同一の記述仕様に対し、`claude -p` による自律実行を1回のみ(リトライなし、人間の介入なし)行いました。品質は、実際のブラウザですべての基準を検証するヘッドレスPlaywright E2Eテストおよび `npm run build` によって確認しました。コストとトークン数は実行アーティファクトとゲートウェイの監査ログから取得し、UXは同一ビューポートのスクリーンショットからレビューしました。2026年6月。
実測 · マルチモデルベンチマーク2026年6月検証済み
5つのモデル、同一アプリ、コーディングおよびルーティング層
すべてのモデルが、弊社独自のCLIであるPalguエージェントを通じて、同じNext.js 15 + TypeScript + Tailwindアプリ(「Council Brainstorm」)をエンドツーエンドで構築し、8項目のPlaywright受け入れテストスイートに合格するまでイテレーションを行いました(最大4ラウンド)。ゲートウェイが各モデルをそのまま提供するよう、モデルは固定されました。精度、速度、出力トークン数、コスト、UIの完成度で採点しています。
コーディングティア(フルアプリビルド)
| モデル | 受け入れ判定 | ビルド | 出力トークン | 実時間 | コスト | UIの完成度 |
|---|
| GLM-5.2Z.ai | 8/8 | 合格 | 54.5k | 22.3分 | ≈$0.12 | 最良(ダークテーマ、色分け表示) |
| DeepSeek-V4 ProDeepSeek | 8/8 | 合格 | 43.5k | 7.8 min | ≈$0.04 | クリーン、最高のコストパフォーマンス |
| Claude Opus 4.8Anthropic | 7/8 | 合格 | 41.0k | 11.4分 | ≈$25.73 | 最も洗練されたUI |
| Kimi 2.7Moonshot | 7/8 | 合格 | 22.2k | 7.7 min | ≈$0.06 | 機能的、スタイル未適用 |
| GPT-5.5OpenAI | 0/8 | 失敗 | 0 | — | — | ビルド失敗 |
ルーティング層:小規模で限定的なタスク(すべて正答率100% → 速度が決め手)
| モデル | 精度 | タスクあたり | 閲覧 |
|---|
| Cerebras | 100% | 1.0s | 最速: サブ秒、完璧 |
| Kimi-highspeed | 100% | 1.5s | ほぼ同等の速さ、完璧な結果 |
| Gemini | 100% | 4.7s | 最少のトークン消費、かつ高速 |
| DeepSeek-V4 Pro | 100% | 5.8s | 高精度・中速 |
| MiniMax-2.5 | 100% | 6.2s | 高精度・中速 |
| GLM-5.2 | 100% | 15.3s | 高負荷: ルーティング用ではなくコーディング用のモデル |
単一の「ベスト」モデルは存在しません。ビルド品質ではGLM-5.2(最もクリーンなUIで唯一の8/8)、コストパフォーマンスではDeepSeek-V4 Pro(同じく8/8、2.9倍高速、最安コスト)、ルーティング層の速度ではCerebrasが勝利しました。このばらつきこそが、ルーティング層が存在する最大の理由です。
より安価なモデルが圧倒的な勝利を収めました。GLM-5.2は同じアプリをビルドし、ごくわずかなコストでClaude Opusよりも高いスコア(8/8 対 7/8)を記録しました。同一条件で比較すると(GLMの入力トークンは計測されなかったため、$0.12は出力のみの金額)、Opusの約$25.73と比べて約25分の1のコストであり、出力トークン単体で見ればさらに大きな差となります。表面上のトークン単価は見るべき指標ではありません。
GPT-5.5は変換されたサービングパスで失敗しました(空のターン)。モデルを固定していたため、ゲートウェイの空ターン・フェイルオーバーがオフになっており、エラーがそのまま表面化しました。このモデルではフェイルオーバーをオンにしておく必要があります。これは課金上の不整合ではなく、実際の信頼性に関する発見です。
測定方法。 すべて自社のスタック(Palguゲートウェイ + PalguエージェントCLIのドッグフーディング)上で実行しました。精度はPlaywright(8つの受け入れ基準)で測定し、UIの完成度は同一ビューポートのスクリーンショットから判定しました。コストはトークン数から算出した定価ベースの値です(より正確な数値はゲートウェイの監査ログとなります)。一部のモデルではクライアント側で入力トークンが計測されなかったため、出力のみの控えめなコストとなっています。1セント単位の厳密な比較ではなく、傾向の比較としてご参照ください。モデルはルーティングされずそのまま提供されるよう、x-srooter-pinでピン留めしました。2026年6月。
ユースケース × モデル適性| ユースケース | Claude Opus4.8 | GLM5.3 | MiniMax-M2M2 | MiniMax-M3M3 | Gemini3.1 Pro | DeepSeekV3.2 | Cerebrasgpt-oss-120b | Qwen332B |
|---|
| コーディングエージェント | | ルーティング先 | | | | | | |
| リポジトリ全体 / ロングコンテキスト | | ルーティング先 | | | | | | |
| アーキテクチャおよびセキュリティレビュー | ルーティング先 | | | | | | | |
| 軽微な編集・雑務 | | | | | | | ルーティング先 | |
| 一括抽出・分類 | | | | | ルーティング先 | | | |
| 難易度の高いデバッグと推論 | | | | | | ルーティング先 | | |
最適 有力 実用 Palguのルーティング先
モデルリファレンスPalguがルーティングする対象モデル、そのバージョン、および各モデルの強みです。SWE-bench Verifiedの数値は外部のエビデンスです(概算値、注記を参照)。
Claude Opus4.8
Anthropic
フロンティア領域のコーディング、アーキテクチャおよびセキュリティの判断
- コンテキスト:
- 200K(1M ベータ)
- SWE-bench:
- ~88.6%
GLM5.3
Z.ai
Palguの本格的なコーディングのデフォルト(ADR-079):フロンティアモデルの数分の一のコストで最高のビルド品質を実現
- コンテキスト:
- ~200K
- SWE-bench:
- 自社検証: 8/8ビルド達成、デフォルトA/Bテストで勝利(2026年8月)
MiniMax-M2M2
MiniMax
わずかなコストでフロンティアに迫るコーディング性能
- コンテキスト:
- ~205K
- SWE-bench:
- ~80%(オープンウェイトのリーダー)
MiniMax-M3M3
MiniMax
切り捨てのないリポジトリ全体 / ロングコンテキスト処理
- コンテキスト:
- 1M
- SWE-bench:
- —
Gemini3.1 Pro
Google
マルチモーダル、一括抽出、根拠に基づくリサーチ
- コンテキスト:
- 1M+
- SWE-bench:
- ~80.6%
DeepSeekV3.2
DeepSeek
強力な推論・デバッグ能力、超低コスト
- コンテキスト:
- 128K
- SWE-bench:
- ~73%
Cerebrasgpt-oss-120b
Cerebras
Palguの軽微なタスク層のデフォルト:コミットや雑務向けの最速の有料推論
- コンテキスト:
- 128K
- SWE-bench:
- —
Qwen332B
Alibaba
簡単なやり取り向けのローカル/低コストなフォールバック
- コンテキスト:
- 256K
- SWE-bench:
- —