نحن لا نبيع أرخص رمز (token) ولا نطارد رقمًا وحيدًا متنازعًا عليه في لوحات الصدارة. يقيس Palgu الأداءَ وفق حالات استخدام المطورين، ويوجه كل طلب تلقائيًا إلى النموذج الذي ينجز العمل، عبر نقطة طرفية واحدة. إليك أدناه كيف نوجّه الطلبات، والأدلة التي تستند إليها قراراتنا.
«تنفيذ ميزة أو إعادة هيكلة الكود عبر ملفات متعددة»
وكيل البرمجة
تُوجَّه مهام البرمجة اليومية متعددة الملفات إلى GLM-5.3، وهو النموذج الافتراضي الأساسي في Palgu (ADR-079) الفائز في اختبار A/B الداخلي للنموذج الافتراضي؛ إذ أنجز تطبيقاً يعمل بالكامل بنتيجة 8/8 من المحاولة الأولى وبأقل تكلفة بين النماذج الثلاثة المختبرة. أما المهام الأعلى حساسية فتُصعَّد إلى Claude Opus + المجلس، مع إمكانية تثبيت أي نموذج لكل طلب. ولا نُخفِّض مستوى نموذج البرمجة بصمت من أجل الميزانية وحدها.
يوجه Palgu إلى
GLM
Z.ai
حصيلة الإنتاجية
صحة طلبات الدمج (PR) من المحاولة الأولى، وجولات مراجعة أقل
الدليل · اختبار A/B داخلي للنموذج الافتراضي
GLM-5.3 بنتيجة 8/8 من المحاولة الأولى · يتصدر معادلة السعر×الجودة×السرعة مقابل kimi-k3 وGLM-5.2 · موثَّق عبر المتصفح
الجيل الحالي من النماذج الطليعية (gemini-3.7-flash و glm-5.3 و kimi-k3 و claude-fable-5.1 و gpt-5.6-terra و gpt-6-astra) بنى كلٌّ منها التطبيق الكامل نفسه (تطبيق Council Brainstorm: تسجيل دخول بالبريد الإلكتروني، ومجلس من ثلاثة محاورين مع خلاصة تركيبية، ومحادثات مستمرة قابلة للبحث) عبر وكيل Palgu، مع تثبيت الإصدار وتقديم المخرجات كما هي دون تعديل. جرى التقييم بناءً على 8 فحوصات قبول عبر Playwright مع لقطات شاشة. أطلقت النماذج الستة جميعها تطبيقًا فاعلًا بنتيجة 8/8، لذا فإن الفيصل هنا هو التكلفة والسرعة، لا مجرد النجاح أو الفشل. التكلفة = عدد التوكنات × السعر المعلن لعملية بناء واحدة.
النموذج
القبول
الزمن الفعلي
التكلفة / البناء
الجودة (واجهة المستخدم)
ملاحظات
gemini-3.7-flashGoogle
8/8
689s
$0.46
واجهة داكنة متقنة، ومحرر واعٍ بالسياق
الأرخص بين الستة: بناء نظيف من دورة واحدة؛ أفضل قيمة
glm-5.3Z.ai
8/8
780s
$1.19
سمة فاتحة هادئة، وعلامات لتحديد الأدوار
8/8 من المحاولة الأولى: النموذج الافتراضي الاقتصادي من Palgu يصمد أمام النماذج الطليعية
kimi-k3Moonshot
8/8
667s
$1.83
مظهر داكن، وتصميم الأسئلة على شكل فقاعات دردشة
منخفض التكلفة وسريع؛ بناء نظيف
claude-fable-5.1Anthropic
8/8
386s
$5.91
مظهر فاتح، بطاقات أدوار مرمزة بالألوان
أسرع بناء بين الستة (386s)، من جولة واحدة
gpt-5.6-terraOpenAI
8/8
2581s
$6.07
أغنى واجهة داكنة، وشارات أدوار بالرموز التعبيرية
تباين عالٍ: البناء الأول صدر معطوباً (خطأ SQLite أثناء التشغيل، 1/8)؛ واجتازت إعادة التشغيل الاختبار بنتيجة 8/8 لكنها كانت الأبطأ (43 min)
gpt-6-astraOpenAI
8/8
1074s
$26.52
أغنى بيانات وصفية + هوية بصرية متدرجة الألوان
الأحدث والأغلى: نفس نتيجة 8/8 بتكلفة تعادل 58× تكلفة gemini؛ يستهلك 2.35M من رموز المدخلات في التفكير دون أي تفوق في الجودة
سلّمت النماذج الستة تطبيقاً متكاملاً ومصقولاً بنتيجة 8/8، ما يعني تعادلاً فعلياً في الجودة. تتضمن كل نسخة تسجيل الدخول، وبطاقات المجلس الثلاث المصنفة حسب الأدوار، والخلاصة، والبحث، وحفظ البيانات. لم يعد السؤال الصحيح "أي نموذج ذكي بما يكفي"؛ فجميعها كذلك.
التفاوت الحقيقي يكمن في التكلفة: فارق يصل إلى 58 ضعفًا بين الأرخص والأغلى للحصول على النتيجة ذاتها. يبنيه نموذج gemini-3.7-flash مقابل $0.46؛ بينما يكلف gpt-6-astra مبلغ $26.52. تهيمن توكنات الإدخال على الفاتورة (إذ يُعاد إرسال السياق عبر ما يصل إلى 90 دورة للوكيل)، ويستهلك Astra نحو 2.35M منها في التفكير المطول دون أي ميزة إضافية في الجودة.
تشغيل ناجح واحد لا يعني الموثوقية. سلّم نموذج gpt-5.6-terra نسخة معطوبة في المحاولة الأولى؛ تم تصريف الكود بنجاح، لكن مسار تسجيل الدخول انهار وقت التشغيل (SQLITE_ERROR) بنتيجة 1/8. نجحت إعادة التشغيل بنتيجة 8/8، لكنها استغرقت 43 دقيقة. تعامل مع التباين بين التشغيلات كحقيقة واقعة.
الخلاصة
تزدحم الساحة بنماذج الطليعة في البرمجة الوكيلية، ومعظمها قادر على إنجاز المهمة. ولم يعد اختيار النموذج الأحدث والأغلى قراراً يتعلق بالجودة، بل قراراً بدفع عشرات الأضعاف مقابل النتيجة نفسها. وهذا الاختيار لكل طلب، أي انتقاء النموذج الأوفر الذي يحقق معيارك، هو تحديداً ما يوجّهه Palgu.
المنهجية. بنى كل نموذج نفس المواصفات (SPEC) عبر وكيل Palgu من خلال البوابة، مع التثبيت (x-srooter-pin) ليقدمه الموجّه مباشرة؛ وحُدد سقف التكرار حتى النجاح عند 3 جولات بحد أقصى 30 دقيقة من الزمن الفعلي لكل تكرار. الدقة = 8 فحوصات Playwright (من A1 إلى A8) تُنفَّذ على بناء الإنتاج (PRODUCTION) وليس التطوير (dev). التكلفة = التوكنات × تقدير السعر المعلن (الرقم الأدق هو تكلفة التدقيق في البوابة). قُيّمت الجودة من لقطات شاشة بأبعاد عرض متطابقة. بناء واحد لكل نموذج (أُعيد أخذ عينة لنموذج terra مرة واحدة بعد بناء شابه خطأ وقت التشغيل). سبتمبر 2026.
مقيس · اختبار A/B للنموذج الرائد مقابل الافتراضي
موثّق في أغسطس 2026 · مقيم وفق السعر 50% · الجودة 30% · السرعة 20%
بناء تطبيق Personal CFO — أي نموذج يجب أن يكون الافتراضي؟
مواصفة واحدة، ثلاثة نماذج، ونفس الـ harness (وكيل Palgu، مثبت، مع التكرار حتى الاجتياز): تطبيق مدير مالي شخصي (Personal CFO) يضم تسجيل دخول بالبريد الإلكتروني، وتتبع الدخل والمصروفات، ومديراً مالياً حوارياً يجيب عن سؤال "هل أستطيع تحمل تكلفة هذا؟" بحكم موثق وقابل للتحقق آلياً. سلّم كل نموذج تطبيقاً عاملاً بنتيجة 8/8، لذا يعتمد الترتيب على معادلة المشغّل (السعر × الجودة × السرعة) وليس مجرد النجاح أو الفشل. التكلفة هي عدد الرموز حتى أول نتيجة 8/8 مضروباً في السعر المعلن.
النموذج
القبول
الجولات
التكلفة
الزمن الفعلي
النتيجة
ملاحظات
glm-5.3Z.ai
8/8
1
$1.71
19 دقيقة
0.896
الافتراضي الجديد (ADR-079): الأرخص وحقق 8/8 من المحاولة الأولى؛ يتصدر التقييم الموزون
kimi-k3Moonshot
8/8
1
$2.18
9 min
0.893
بطل السرعة (أسرع بمرتين)، لكن بسعر أعلى بنحو 5.5 مرة لكل توكن ← تكلفة إجمالية أعلى
glm-5.2Z.ai
8/8
2
$1.72
25 دقيقة
0.871
الافتراضي السابق — احتاج إلى دورة ثانية؛ بينما يتفوق عليه glm-5.3 من المحاولة الأولى
تسلّم النماذج الثلاثة تطبيقاً يعمل بكفاءة بنتيجة 8/8، لذا فإن النتيجة الإجمالية هي الحاسمة وليس مجرد النجاح أو الفشل. وفقاً لتوزيع الأوزان الخاص بالمشغّل (السعر 50 / الجودة 30 / السرعة 20)، تقاربت النماذج الثلاثة بفارق ~2.5 نقطة: أداء متكافئ، مع تقدم طفيف لنموذج glm-5.3.
أصبح glm-5.3 الخيار الافتراضي الجديد (ADR-079): فهو الأرخص بين الثلاثة، وأنجز البناء من المحاولة الأولى في تكرار واحد، في حين احتاج glm-5.2 إلى تكرارين. هذا هو الاختبار المباشر الذي حسم الانتقال؛ إذ يتفوق glm-5.3 تفوقًا ملموسًا على النموذج الذي حلّ محله.
لا سرعة بلا ثمن: يبني kimi-k3 بسرعة 2× (9 مقابل 19 دقيقة) لكن بسعر رموز أعلى بنحو ~5.5×، ما يجعله أعلى تكلفة في المجمل. وجّه نحو kimi-k3 للسرعة، ونحو glm-5.3 لأقل تكلفة لكل بناء مكتمل.
ملاحظة. تشغيلة واحدة لكل نموذج (n=1)؛ يتفاوت عدد الرموز بين تشغيلة وأخرى، لذا يُفهم هذا على أنه «تكافؤ مع تقدم glm-5.3»، وليس تفوقاً ساحقاً. سُعّر glm-5.3 وفق الشريحة المدمجة لـ glm-5.2 ($0.0011/1k) ريثما يؤكد Z.ai السعر الرسمي للنموذج الرائد؛ وبما أن السعر يمثل 50% من النتيجة، فإن أي سعر فعلي أعلى سيقلّص الفارق.
المنهجية. نفس harness البناء بالوكيل المستخدم في دراسة يوليو، على مؤسسة الاختبار المعزولة: ثُبّت وكيل Palgu عبر x-srooter-pin لتقدم البوابة كل نموذج مباشرة؛ مع التكرار حتى النجاح أمام حزمة قبول Playwright من 8 نقاط (تسجيل الدخول ← الدخل ← النفقات ← ملخص الشهر ← حكم القدرة على التحمل) بسقف محدد. النتيجة = 0.5·السعر + 0.3·الجودة + 0.2·السرعة، مع تطبيع كل منها نسبةً إلى أفضل تشغيل؛ التكلفة = التوكنات حتى أول نتيجة 8/8 × السعر المعلن للإعداد. أغسطس 2026.
مقيس · معيار بناء الوكيل
موثّق في يوليو 2026
منافسة بناء برمجي بين تسعة نماذج
وكيل واحد، تطبيق كامل واحد: تسجيل دخول بالبريد الإلكتروني، و"مجلس" من ثلاثة محاورين مع خلاصة تركيبية، ومحادثات مستمرة، وبحث في النص الكامل. التقييم على محورين: (1) 8 فحوصات قبول عبر المتصفح (هل يعمل؟)، (2) درجة إتقان من 0 إلى 5 تُقيَّم يدوياً للبناء النهائي (هل هو متقن؟). اجتازت ثمانية من أصل تسعة نماذج الفحوصات الثمانية كاملة، لذا تتساوى نتيجة النجاح/الفشل، ويبقى الإتقان هو الفارق بينها. جرى تثبيت كل نموذج (يُخدَّم كما هو دون توجيه) مع التكرار حتى الاجتياز ضمن سقف محدد. الأوقات هي الزمن الفعلي المنقضي، والرموز هي رموز المخرجات. رُتبت الصفوف حسب الإتقان ثم الكفاءة.
النموذج
القبول
الإتقان
البناء
الجولات
الزمن الفعلي
رموز المخرجات
ملاحظات
kimi-k3
8/8
اجتياز
2
1208s
36.9k
جديد · نموذج Moonshot الرائد: إتقان 5/5 بأقل عدد من التكرارات (2)؛ الأرخص لتحقيق 5/5 من حيث تكلفة البناء
claude-opus
8/8
اجتياز
3
652s
40.8k
الأسرع بنتيجة 5/5 (652s)، أعلى إتقان وأداء سريع
claude-fable-5
8/8
اجتياز
3
763s
47.5k
أعلى درجات الإتقان: سمة داكنة، وعناوين فرعية للأدوار، وتنبيه سلس للبيانات التجريبية (stub)
gpt-5.6-sol
8/8
اجتياز
3
2196s
73.3k
نموذج طليعي رائد: أعلى درجات الإتقان، لكنه أبطأ بنحو 3–4× ويستهلك ~2× من الرموز
gpt-5.5
8/8
اجتياز
2
519s
28.0k
شخصيات مسماة + وسوم أدوار، مظهر داكن أنيق
glm-5.2
7/8
اجتياز
4
602s
34.7k
الإخفاق الوحيد: فحص عدد المحاورين؛ بناء قوي بمظهر داكن
gpt-5.6-terra
8/8
اجتياز
2
1194s
43.2k
الفئة المتوازنة من GPT-5.6 (≈ GPT-5.5)، شريط إعدادات منسّق
deepseek-pro
8/8
اجتياز
1
505s
31.7k
الأسرع، 8/8 من تمريرة واحدة، لكن بواجهة مستخدم أبسط (تسرّب markdown خام)
kimi-2.7-code
8/8
اجتياز
3
772s
30.7k
اجتاز الاختبار، لكن بأبسط بناء ممكن — بطاقات مسطحة، دون تصميم للأدوار
نجحت ستة نماذج من أصل ثمانية في بناء تطبيق يعمل بكفاءة محققة علامة كاملة 8/8، لذا لا يصلح معيار النجاح/الفشل لترتيبها. قيّمنا يدويًا كل بناء مكتمل من 0 إلى 5 من حيث التخطيط، وتصميم الأدوار، والتراجع السلس عند الأخطاء. هنا يكمن التفاوت الحقيقي.
مستوى الإتقان يعكس فئة النموذج: قدمت نماذج Opus و Fable و Sol بناءً بتقييم 5/5 (أدوار محاورين مرمزة بالألوان، ومعالجة سلسة لحالة عدم توفر مفتاح API)؛ بينما اجتاز DeepSeek و Kimi الفحوصات ذاتها لكن بواجهات مستخدم أبسط (3/5 و 2/5). سقف التقييم 8/8 أخفى هذا الفارق تحديدًا.
يتصدر المشهدَ رائدٌ جديد في القيمة مقابل السعر: يحقق Kimi K3 مستوى الإتقان ذاته (5/5) الذي يحققه Opus / Fable / Sol، ولكن بتكلفة ~$3.60 لكل بناء (أي نصف تكلفة Opus وثلث تكلفة Fable)، كما حقق 8/8 بأقل عدد من التكرارات (2). المفاضلة الوحيدة هي السرعة (1208s؛ إذ إن النموذج الرائد بأقصى استدلال أبطأ من Opus البالغ 652s). لا يوجد فائز أوحد؛ وجّه المهام التي تتطلب أعلى إتقان وجودة إلى K3 (الأرخص بفئة 5/5) أو Opus (الأسرع بفئة 5/5)، ووجّه المهام كثيفة الحجم إلى النماذج السريعة والكافية (DeepSeek / GPT-5.5).
المنهجية. تشغيل مستقل في يوليو 2026 شمل تسعة نماذج بما فيها Kimi K3 (مقابل قسم «النماذج الخمسة» ليونيو أدناه) على harness محسَّن: أدت إصلاحات التعافي من الأدوار الفارغة وحلقات الأدوات إلى حل فشل بناء GPT-5.5 المسجل في يونيو، كما أُضيف مراقب لكل تكرار وتنظيف للمنافذ. جرى تثبيت كل نموذج (تقديمه مباشرة دون توجيه)، مع سقف للتكرار حتى النجاح عند 5 جولات؛ الأوقات المسجلة هي الزمن الفعلي، والتوكنات هي للمخرجات. درجة الإتقان من 0 إلى 5 هي تقييم يدوي تقديري لكل بناء مكتمل (التخطيط، وتصميم أدوار المحاورين، والتعامل السلس عند غياب الإعدادات) استنادًا إلى لقطات شاشة بأبعاد عرض متطابقة مع الكود المصدري، وليست مقياسًا آليًا. يتفاوت القبول من تشغيل لآخر في الفحص الشكلي لعدد المحاورين (ولهذا قد يحقق Opus وGLM-5.2 نتيجة 7/8 في تشغيل و8/8 في آخر). هذه أرقام هذا التشغيل ولا تلغي قسم يونيو المستقل.
منظور التسعير · تكلفة بناء التطبيق نفسه
منظور التسعير — كم يكلف الإتقان
التطبيق نفسه، وتكلفة بنائه على كل نموذج بالسعر المعلن (بثبات ~1M توكن إدخال + 40k توكن إخراج، وهو متوسط اختبار البناء). النقاط تمثل تقييم الإتقان اليدوي. السؤال الذي يجيب عنه الموجه مع كل طلب: ما أرخص نموذج يتجاوز سقف الجودة المطلوب؟
النموذج
الإتقان
تكلفة البناء ←
السعر المعلن · مدخلات / مخرجات لكل 1M
deepseek-proالأقل تكلفة لإنجاز الإطلاق
$0.47
$0.44 / $0.87
glm-5.2أفضل قيمة بنتيجة 4/5
$1.14
$1.10 (تكلفة مدمجة)
gpt-5.6-lunaفئة التكلفة (لم يُبنَ)
غير متاح
$1.24
$1.00 / $6.00
kimi-2.7-codeتكلفة أعلى مقابل أداء أقل
$1.77
$1.70 (تكلفة مدمجة)
gpt-5.6-terraمتوازن
$3.10
$2.50 / $15.00
kimi-k3الأقل تكلفة بنتيجة 5/5 · رائد
$3.60
$3.00 / $15.00
claude-opusالأسرع بنتيجة 5/5
$6.00
$5.00 / $25.00
gpt-5.6-solسقف الطليعة · أبطأ 3–4×
$6.20
$5.00 / $30.00
gpt-5.5سعر فئة رائدة، بناء 4/5
$6.20
$5.00 / $30.00
claude-fable-5فئة عليا 5/5
$12.00
$10.00 / $50.00
يتطلب إتقاناً بدرجة 5/5
kimi-k3
$3.60 لكل عملية بناء: الأقل تكلفة بتقييم 5 نجوم، يضاهي إتقان Opus/Fable (بينما Opus أسرع بتكلفة $6.00)
أداء قوي 4/5، ومنخفض التكلفة
glm-5.2
$1.14 لكل عملية بناء: أقل بـ 5× من النماذج الرائدة، وبفارق درجة واحدة في الإتقان
المهم أن يؤدي الغرض
deepseek-pro
$0.47 لكل عملية بناء: ينجز 8/8 من المحاولة الأولى، مع واجهة مستخدم أبسط
أعاد Kimi K3 رسم معايير الفئة العليا: الإتقان نفسه بنتيجة 5/5 كنماذج Opus / Fable / Sol بتكلفة $3.60 لكل بناء، ليكون الأوفر بين النماذج التسعة من فئة 5 نجوم (نصف تكلفة Opus، وثلث Fable). أما النماذج الرائدة الأخرى فتمثل شريحة سعرية لمسار أبطأ أو أعلى تكلفة نحو المعيار ذاته: يكلّف gpt-5.6-sol ما يكلّفه Opus لكنه أبطأ بنحو 3–4×؛ ويفرض gpt-5.5 أسعار النماذج الرائدة مقابل بناء بتقييم 4/5. اختر النموذج الأوفر الذي يحقق معيارك؛ فهذا التوجيه لكل طلب هو جوهر Palgu.
السعر المعلن، بدون تخزين مؤقت. عمليات البناء الوكيلية الفعلية تخزن بادئة المدخلات مؤقتاً (أرخص بنحو ~10× في المدخلات)، لذا تكون التكلفة المطلقة بالدولار ($) أقل، مع بقاء الترتيب كما هو. يُعرض كل من GLM وKimi بالسعر المدمج في إعدادات البوابة (دون فصل معلن بين المدخلات والمخرجات).
مقيس · معيار قياس داخلي
موثّق في يونيو 2026
بناء تطبيق كامل من المحاولة الأولى
بناء تطبيق كامل في دورة ذاتية واحدة: تسجيل دخول بالبريد الإلكتروني، و"مجلس" متعدد الرؤى يجيب عبر ثلاثة محاورين مع خلاصة جامعة، ومحادثات محفوظة، وبحث في كامل النص. نفس المواصفات ونفس الـ harness؛ مع قياس الأداء وفق الجودة والتكلفة والسرعة.
المقياس
Claude Opus 4.8 (مباشر)
Claude Fable-5 (مباشر)
Palgu (توجيه محكوم)
معايير القبول (اختبار E2E في المتصفح)
8/8
8/8
8/8
يجتاز فحص الأنواع والبناء (npm run build)
اجتياز
اجتياز
اجتياز
تكلفة البناء (المقاسة)
$3.02
$3.05
≈$1–3
الزمن الفعلي المنقضي
7.96 min
5.95 min
10–16 دقيقة
الرموز المعالجة
2.43M
1.06M
3.6–4.5M
خطوات الوكيل
43
39
53–66
إتقان تجربة المستخدم (UX) (مُقيّم من لقطات الشاشة)
4.5/5
5/5 ★
4/5
السعر لكل توكن هو المعيار الخاطئ: تكلفة Fable-5 تبلغ نحو ضعف Opus لكل توكن، لكنه استهلك توكنات أقل بنحو 2.3 مرة، ما يعني تكلفة إجمالية متطابقة (~$3) وبسرعة أكبر بنسبة 25%. حسّن إجمالي التوكنات اللازمة للإنجاز.
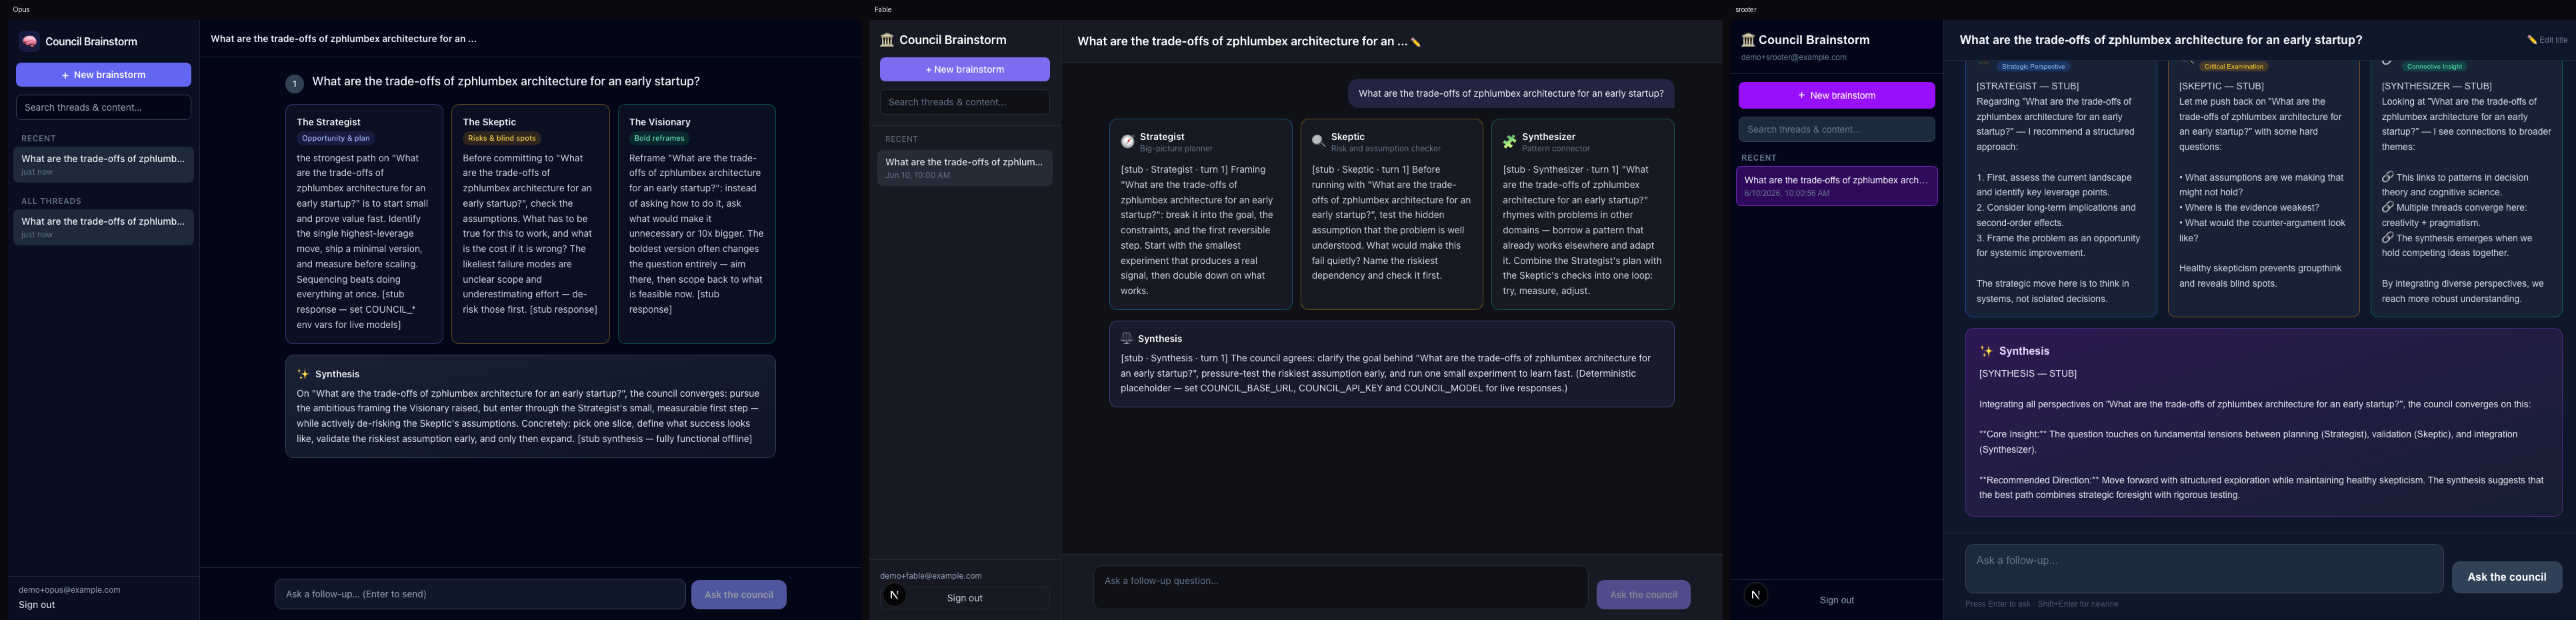
قدّم Palgu نفس التطبيق المجتاز للبناء بنتيجة 8/8 عبر التوجيه المحكوم للنماذج الاقتصادية، بنحو نصف إلى ثلث تكلفة النماذج الطليعية المباشرة، مقايضاً الزمن الفعلي المنقضي بالتكلفة والحوكمة (الميزانيات، التدقيق، السياسات).
تُقاس تكلفة Palgu عند سجل تدقيق البوابة: فعدادات جهة العميل تسعّر الأنظمة الخلفية الموجَّهة بأسعار النموذج المطلوب، مما قد يضخم الإنفاق الفعلي بمقدار 5–10×.
التطبيق ذاته، بُني ذاتيًا بثلاث طرق (من اليسار إلى اليمين: Opus 4.8 · Fable-5 · Palgu). حققت الطرق الثلاث: 8/8 من معايير القبول، وعمليات بناء نظيفة مجتازة لفحص الأنواع.
Claude Fable-5 مقابل Opus 4.8: فارق كفاءة استهلاك الرموز
السعر لكل توكن
Fable-5 ≈ 2.0× Opus ($10/$50 مقابل $5/$25 لكل مليون رمز إدخال/إخراج)
الرموز اللازمة لإنجاز التطبيق ذاته
1.06M مقابل 2.43M: استهلك Fable أقل بمقدار 2.3×
النتيجة الصافية
إجمالي التكلفة بفارق لا يتجاوز 1% (~$3 لكل منها) · Fable أسرع بنسبة 25% (5.95 مقابل 7.96 دقيقة) · خطوات تفاعل أقل (39 مقابل 43)
الجودة
حقق كلاهما 8/8 في متصفح فعلي؛ وأنتج Fable واجهة المستخدم الأكثر إتقاناً بين النسخ الثلاث (بطاقات محاورين مصنفة حسب الدور، وتسلسل هرمي هو الأوضح)
النموذج الأقوى الذي ينجز المهمة من المحاولة الأولى وفي خطوات أقل قد يكون أرخص وأسرع من نموذج "أرخص" يحتاج إلى محاولات أكثر. هذا هو المؤشر الذي يعتمد عليه Palgu في التوجيه: عدد الرموز حتى الإنجاز، وليس السعر المعلن لكل رمز.
المنهجية. مواصفات واحدة، وharness واحد: حصل كل إعداد على تشغيل ذاتي واحد للأمر `claude -p` (دون إعادة محاولة أو مساعدة بشرية) وفق نفس المواصفات المكتوبة ذات معايير القبول الثمانية. جرى التحقق من الجودة عبر اختبار Playwright E2E بلا واجهة رسومية يختبر كل معيار في متصفح حقيقي إلى جانب `npm run build`؛ وتأتي التكلفة والتوكنات من مخرجات التشغيل وتدقيق البوابة؛ بينما روجعت تجربة المستخدم من لقطات شاشة بأبعاد عرض متطابقة. يونيو 2026.
مقيس · معيار متعدد النماذج
موثّق في يونيو 2026
خمسة نماذج، التطبيق نفسه: فئات البرمجة والتوجيه
بنى كل نموذج التطبيق نفسه باستخدام Next.js 15 + TypeScript + Tailwind ("Council Brainstorm") من البداية إلى النهاية عبر وكيل Palgu (أداة CLI الخاصة بنا)، مع التكرار حتى اجتياز حزمة قبول Playwright المكوّنة من 8 نقاط (بحد أقصى 4 جولات). ثُبِّتت النماذج لتخدِم البوابة كل نموذج منها كما هو. وجرى التقييم وفق الدقة والسرعة ورموز المخرجات والتكلفة وإتقان واجهة المستخدم.
فئة البرمجة: بناء تطبيق كامل
النموذج
القبول
البناء
رموز المخرجات
الزمن الفعلي
التكلفة
إتقان واجهة المستخدم (UI)
GLM-5.2Z.ai
8/8
اجتياز
54.5k
22.3 دقيقة
≈$0.12
الأفضل: مظهر داكن ومصنف بالألوان
DeepSeek-V4 ProDeepSeek
8/8
اجتياز
43.5k
7.8 min
≈$0.04
نظيف: أفضل قيمة
Claude Opus 4.8Anthropic
7/8
اجتياز
41.0k
11.4 دقيقة
≈$25.73
الواجهة الأكثر إتقاناً
Kimi 2.7Moonshot
7/8
اجتياز
22.2k
7.7 min
≈$0.06
يعمل وظيفياً، دون تنسيق
GPT-5.5OpenAI
0/8
إخفاق
0
—
—
فشل البناء
فئة التوجيه — مهام صغيرة ومحددة (جميعها صحيحة بنسبة 100% ← السرعة هي الفيصل)
النموذج
الدقة
لكل مهمة
قراءة
Cerebras
100%
1.0s
الأسرع، أقل من ثانية، مثالي
Kimi-highspeed
100%
1.5s
مقارب في السرعة، مثالي
Gemini
100%
4.7s
الأقل استهلاكاً للرموز، مع الحفاظ على السرعة
DeepSeek-V4 Pro
100%
5.8s
دقيق، متوسط السرعة
MiniMax-2.5
100%
6.2s
دقيق، متوسط السرعة
GLM-5.2
100%
15.3s
ثقيل: نموذج برمجة، لا نموذج توجيه
لا يوجد نموذج واحد "أفضل" على الإطلاق: فاز GLM-5.2 بجودة البناء (الوحيد بنتيجة 8/8 مع أنظف واجهة مستخدم)، وفاز DeepSeek-V4 Pro بالقيمة (حقق أيضاً 8/8، وأسرع بمقدار 2.9×، وبأقل تكلفة)، وفاز Cerebras بفئة التوجيه من حيث السرعة. هذا التفاوت هو السبب الجوهري لوجود طبقة التوجيه.
النموذج الأرخص فاز بجدارة: بنى GLM-5.2 التطبيق نفسه وحقق نتيجة أعلى من Claude Opus (8/8 مقابل 7/8)، وذلك بجزء ضئيل من التكلفة. وعند المقارنة المتكافئة (لم تُحتسب توكنات الإدخال في GLM، لذا فإن تكلفة $0.12 تمثل المخرجات فقط) يظل أرخص بنحو 25 مرة من تكلفة Opus البالغة ≈$25.73؛ بل وأرخص بكثير عند مقارنة توكنات الإخراج وحدها. السعر المعلن لكل توكن هو المعيار الخاطئ.
أخفق GPT-5.5 عبر مسار التقديم المحوَّل لدينا (جولات فارغة)؛ ومع تثبيت النموذج، تتوقف ميزة التحويل التلقائي عند الجولات الفارغة في البوابة، فظهر الخطأ كما هو. أبقِ التحويل التلقائي مفعّلاً لهذا النموذج. وهذه نتيجة موثوقية فعلية، وليست خللاً عابراً في الفوترة.
المنهجية. نُفذ بالكامل على بنيتنا الخاصة: بوابة Palgu + أداة سطر أوامر وكيل Palgu (في استخدام داخلي). قيسَت الدقة عبر Playwright (8 معايير قبول)؛ وقُيّم إتقان واجهة المستخدم من لقطات شاشة بأبعاد عرض متطابقة. التكلفة محسوبة من السعر المعلن للتوكنات (الرقم الأدق هو تدقيق البوابة)؛ ولم يَقِس العميل توكنات المدخلات لبعض النماذج، لذا تقتصر تكلفتها على المخرجات فقط وتبدو أقل من الواقع، فاجعل المقارنة استرشادية لا بالسنت الدقيق. ثُبّتت النماذج عبر x-srooter-pin ليُقدَّم كل منها مباشرة بدلًا من توجيهه. يونيو 2026.
ملاءمة النموذج لحالة الاستخدام
حالة الاستخدام
Claude Opus4.8
GLM5.3
MiniMax-M2M2
MiniMax-M3M3
Gemini3.1 Pro
DeepSeekV3.2
Cerebrasgpt-oss-120b
Qwen332B
وكيل البرمجة
موجَّه
المستودع الكامل / السياق الطويل
موجَّه
مراجعة البنية المعمارية والأمان
موجَّه
تعديلات سريعة ومهام صيانة
موجَّه
استخراج وتصنيف بالجملة
موجَّه
تصحيح الأخطاء المعقّدة والاستدلال
موجَّه
الأنسب قوي مقبول Palgu يوجّه إلى هنا
مرجع النماذج
النماذج التي يوجه Palgu المهام عبرها، مع إصداراتها ومجالات تفوق كل منها. أرقام SWE-bench Verified تمثل أدلة خارجية (تقريبية، راجع الملاحظة).
Claude Opus4.8
Anthropic
برمجة الطليعة، والهندسة المعمارية، والحكم الأمني
السياق:
200K (1M تجريبي)
SWE-bench:
~88.6%
GLM5.3
Z.ai
النموذج الافتراضي للبرمجة الجوهرية في Palgu (ADR-079) — أعلى جودة بناء بجزء بسيط من تكلفة النماذج الطليعية
تُعرض الاختبارات المعيارية الخارجية بوصفها أدلة موثّقة بالمصدر والتاريخ (جرى التحقق منها في يونيو 2026)؛ لذا تعامل معها كقيم تقريبية. ومن المعروف أن معيار SWE-bench Verified ملوّث جزئياً (وقد انتقلت OpenAI إلى SWE-bench Pro مطلع عام 2026)، ولهذا السبب تحديداً نعتمد مدى الملاءمة لحالة الاستخدام لا رقماً واحداً. وتُمثّل تقييمات الملاءمة توصيات التوجيه من Palgu، وليست درجات مقيسة.